


英伟达将生成式AI引入手术室场景,推出全球首款基于真实胆囊切除术录像训练的实时交互手术模拟器,标志着外科机器人仿真研究迈入临床级视觉环境。
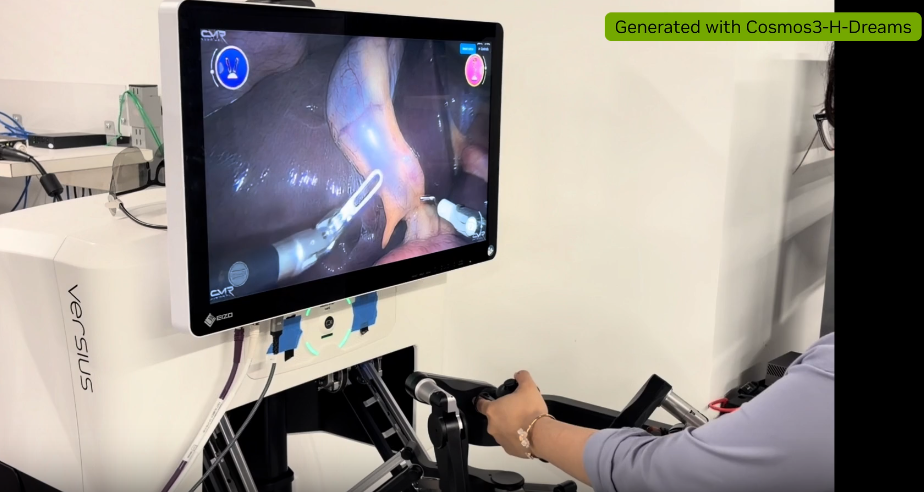
英伟达于10月20日发布Cosmos3-H-Dreams,该系统从CMR Surgical Versius平台的临床手术录像中学习视觉动态,能够根据器械操控指令实时生成新的手术场景续帧,而非简单回放已有手术录像。系统可在单块RTX PRO 6000 GPU上交互式运行。
英伟达明确表示,Cosmos3-H-Dreams是一款研究型模拟器,尚未经过患者护理验证,不适用于临床诊疗。视觉真实感并不等同于生物力学准确性,系统当前仅覆盖特定术式和器械组合,距离临床应用仍有多项验证工作需要完成。对于关注医疗AI赛道的投资者而言,该系统更多代表英伟达在物理AI与手术机器人仿真领域的技术布局,而非近期商业化落地。
从桌面缝合到临床场景
Cosmos3-H-Dreams的前身Cosmos-H-Dreams专注于dVRK平台的桌面缝合任务,背景相对简单。进入人体腔内环境后,视觉复杂度大幅提升:组织在牵拉下形变,反光随器械移动而变化,解剖结构被遮挡,手术烟雾影响能见度。
英伟达此次选取的训练数据来自使用Versius平台实施的临床胆囊切除术录像,聚焦两支可见且处于操作状态的器械——左侧Cadiere抓钳和右侧单极钩。模型以832×480分辨率视频为基础,28个控制维度涵盖双臂位姿、夹持器状态、能量控制及摇杆输入,动作数据以10Hz频率与视频对齐。
英伟达强调,视觉逼真度是验证的起点,而非生物力学准确性的证明。生成画面还必须响应操作者的器械控制指令——平移、旋转与夹持命令需产生合理的解剖学后果,仅靠外观逼真而忽略控制响应的系统无法充当有效的交互环境。
从教师模型到实时推理
Cosmos3-H-Dreams基于Cosmos3-H-Embodied-Nano构建,后者是一个在Open-H-Embodiment数据集上预训练的160亿参数模型。英伟达采用"教师-学生"蒸馏管线,先将双向教师模型在24帧、继而72帧的预测跨度上进行微调,使其充分学习手术动态;随后通过蒸馏将行为迁移至因果学生模型,令其能在新动作到达时逐块生成视频。
针对自回归生成中误差随时间累积的问题,英伟达引入Self-Forcing技术,使学生模型在训练时以自身生成的历史帧作为上下文,并由教师模型与一个习得的评判器共同引导,从而抑制器械形状或解剖结构随生成轮次逐渐漂移的现象。
流式推理由FlashDreams库驱动。为应对长时生成中注意力历史不断膨胀的问题,系统集成了经改造的FadeMem模块,在流式生成过程中对键值缓存进行压缩整合,与Self-Forcing形成互补——前者解决模型如何从生成历史中学习,后者解决该历史如何在推理时被存储。
两个检查点,速度与质量可选
英伟达此次同步发布两个独立训练的推理检查点。
四步检查点每生成一块视频执行四次去噪步骤,优先保障视觉质量;两步检查点则通过进一步专项训练将步数压缩至两步,以一定的视觉质量换取更快的推理速度。英伟达特别说明,两步模型并非直接在四步检查点上减少采样步骤,而是经过独立训练所得。
两个检查点均向开发者开放,并附带完整的教师微调与Self-Forcing蒸馏训练方案,支持适配其他具备同步视频与动作数据的数据集。接入自定义控制器时,动作约定与归一化设置须与训练时保持一致。
研究价值清晰,临床路径尚远
英伟达将Cosmos3-H-Dreams定位为可控仿真研究平台,其核心价值在于为手术机器人研究提供一个能够响应器械指令、具备临床级视觉复杂度的生成式环境,支持探索训练数据以外的未见轨迹,研究器械响应性、组织交互连贯性及解剖结构时序一致性。
系统演示中,两段视频从同一初始帧出发,依据VR头显录制的不同器械动作序列,生成出各异的手术场景续帧,展示了模型对器械控制的响应能力。
然而英伟达明确列出尚未完成的研究议题:更广泛的术式覆盖、生物力学验证、外科医生参与的基准测试,以及对患者护理的适用性评估。这些均是研究方向,而非已建立的临床能力。该系统当前的意义在于为学术研究和器械开发提供一个新的仿真基础设施,而非近期可商业化的医疗产品。
